智能粗筛:把候选镜头变成可检查清单
根据清晰度、重复度与标记信息生成候选片段,再由作者逐条确认是否进入粗剪。
这里展示的是可理解、可复核的工作流,不伪造真实处理结果,也不宣称 AI 能完全替代创作者。每一步都说明工具可以做什么、人工必须检查什么,以及何时应回到原始素材。
按日期、场景和镜头来源建立目录,并保留原始文件名映射,让后续辅助整理和人工复核都有依据。
目录命名越清楚,后续聚类、字幕和版本复盘越容易追溯。
根据清晰度、重复度与标记信息生成候选片段,再由作者逐条确认是否进入粗剪。
依据脚本节拍和素材标签快速形成初版顺序,作者重点检查逻辑跳跃、重复信息与缺失上下文。
自动识别用于生成初稿,发布前仍要检查人名、术语、断句、语气和可能暴露隐私的信息。
尤其是人名、地名、专业词和可能暴露隐私的内容,发布前不能跳过人工逐句检查。
参考镜头长度与音乐段落提示,人工判断哪里需要停顿、哪里需要加速,不让单一评分支配成片。
先标记信息变化。
再确认切点前后是否连续。
给重要画面留出阅读时间。
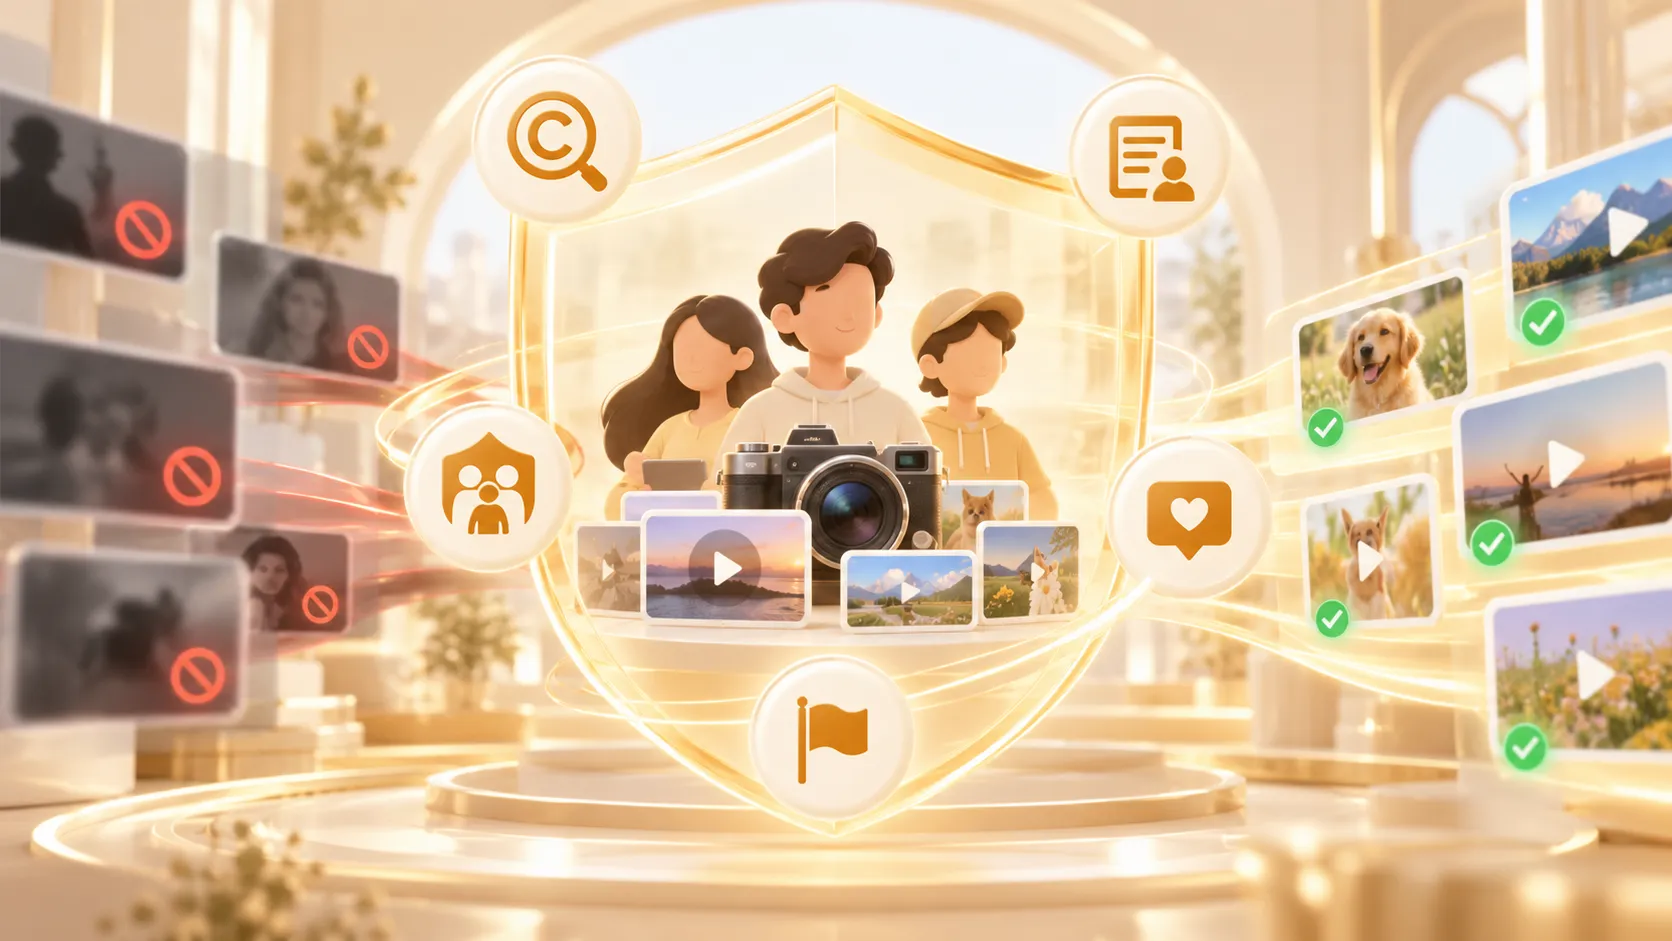
在导出前核对画面人物授权、公开信息准确性、素材来源、字幕语义与不必要的个人识别信息。
事实、字幕、人物授权、素材来源与个人识别信息在这里一起检查,避免把技术完成误认为内容已经可以发布。
先保存高质量母版,再根据横屏、竖屏与移动端浏览场景输出不同尺寸,避免反复压缩原始成片。
母版、横屏和竖屏版本分开管理,能减少重复压缩,也方便以后修改字幕或重新裁切。
发现重复镜头、生成字幕草稿、提供节奏提示和候选片段。
确定故事顺序、删除敏感信息、核对版权与事实,并判断最终节奏是否符合创作意图。
不会。AI剪辑室展示的是辅助工作流,包括素材整理、候选镜头筛选、字幕草稿和节奏提示等环节。故事结构、人物信息、版权、隐私、字幕语义、最终节奏与导出质量仍需要创作者人工判断,页面不会承诺自动化工具能保证成片效果。
当前交互使用浏览器 localStorage 保存收藏与最近浏览,属于本机状态。浏览器阻止存储、隐私模式限制存储,或用户主动清理站点数据时,记录可能无法保存或会被清除。核心正文不依赖这些记录,即使本地存储不可用也能正常浏览。
收藏会保存在当前浏览器中。